Что такое RAG в нейросетях: гайд для новичков и разработчиков
Каждый день отслеживаем ключевые новости технологий, гаджетов и ИИ, отбирая только то, что действительно важно читателю.
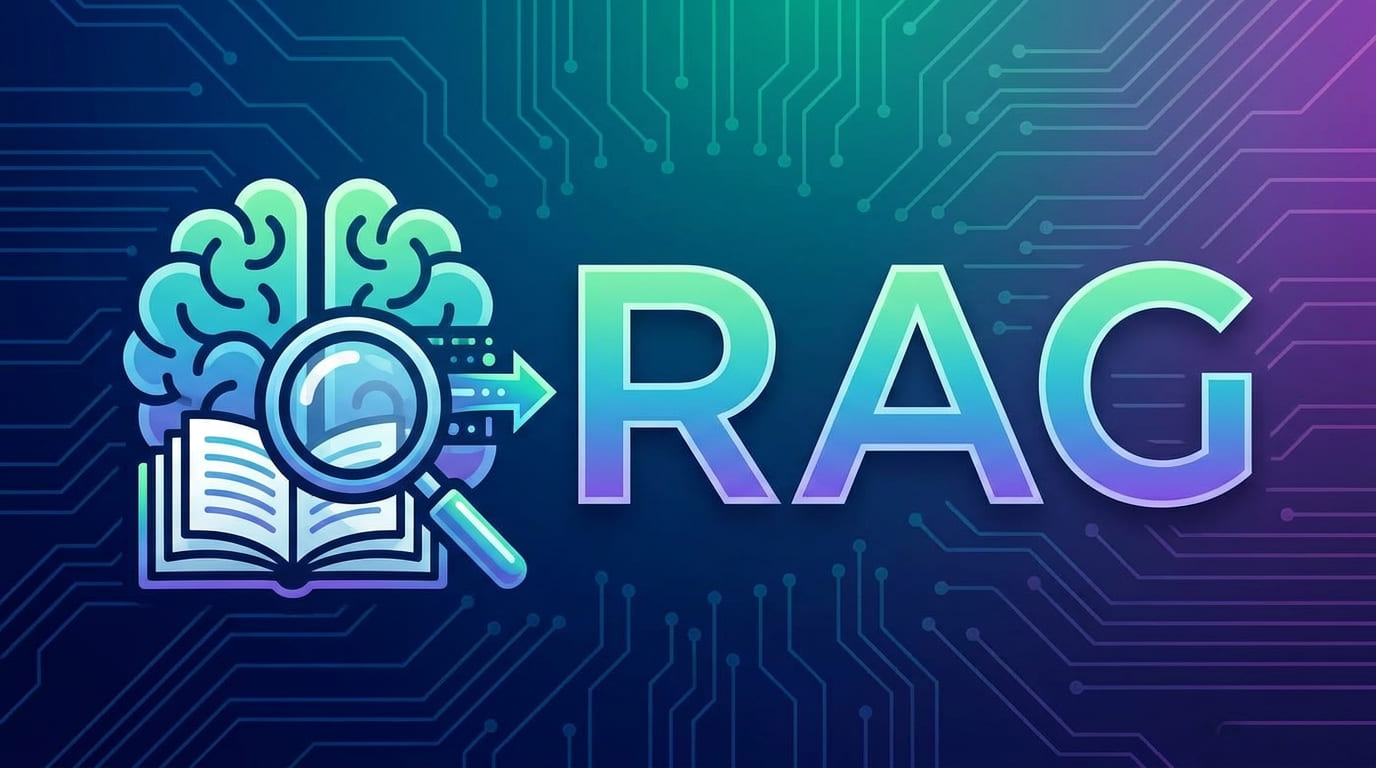
СУТЬ ЗА 30 СЕКУНД
RAG (Retrieval-Augmented Generation) - это технология, которая превращает фантазирующую нейросеть в точного аналитика. Представьте, что студент (языковая модель) пришел на экзамен. Без RAG он отвечает по памяти и может что-то выдумать (галлюцинации). С RAG вы даете ему открытую книгу с точными ответами (вашу базу данных), в которую он заглядывает перед тем, как открыть рот.
Долгое время главной проблемой искусственного интеллекта оставалась его склонность к уверенной лжи. Нейросети выдумывали несуществующие законы, ссылались на фейковые статьи и не знали, что произошло в мире вчера. Решением стала архитектура RAG, которая в 2026 году стала индустриальным стандартом для любого AI-продукта.
Объяснение для новичка: как это работает в жизни
Представьте, что вы загрузили в нейросеть корпоративный регламент на 500 страниц и спрашиваете: "Сколько дней отпуска мне положено?".
Если использовать обычную модель, она либо ответит общими фразами из Трудового кодекса, либо просто ошибется, потому что не помнит ваш конкретный PDF-файл. Модель не может держать в голове все.
Как действует система с RAG:
- Шаг 1: Поиск. Система не сразу генерирует ответ. Сначала она берет ваш вопрос и ищет совпадения по смыслу в загруженных документах.
- Шаг 2: Извлечение. Она находит абзац на 42-й странице, где сказано: "Сотрудникам IT-отдела положено 35 дней отпуска".
- Шаг 3: Генерация. Нейросеть получает невидимый для вас промпт: "Ответь на вопрос пользователя, опираясь только на этот текст: [Текст с 42 страницы]". И выдает вам точный, персонализированный ответ.
RAG не делает нейросеть умнее. Он делает ее информированнее. Вы разделяете "мозги" (LLM) и "память" (ваши данные).
Объяснение для разработчика: под капотом архитектуры
Для инженеров RAG - это пайплайн интеграции информационного поиска (Information Retrieval) и генеративной модели. К 2026 году стек технологий стабилизировался, и сейчас классический RAG выглядит так:
1. Подготовка данных (Chunking & Embedding)
Вы не можете запихнуть всю базу данных в контекстное окно LLM (даже с окном в 2 миллиона токенов это медленно и дорого). Текст нужно разбить на чанки (chunks) - кусочки по 500-1000 токенов. Затем эти чанки прогоняются через Embedding-модель (например, text-embedding-3-large), которая превращает текст в многомерные векторы.
2. Хранение в векторной БД
Векторы складываются в Vector Database. Это специализированные БД (Pinecone, Qdrant, Milvus), оптимизированные для алгоритма ANN (Approximate Nearest Neighbor), чаще всего используется индекс HNSW.
Актуальные цены на 2026 год: Serverless-решения вроде Pinecone тарифицируются примерно по $0.002 за 1K запросов на чтение и $0.008 за 1K записей. Хранение 1 ГБ векторов обойдется около $0.30 в месяц. Для стартапов это копейки.
3. Поиск (Retrieval)
Когда юзер пишет запрос, он тоже превращается в вектор. БД ищет ближайшие к нему векторы (косинусное сходство). В 2026 году обязательным стандартом стал Hybrid Search (семантический поиск + лексический поиск BM25) и Reranking (когда отдельная легкая модель, например от Cohere, пересортировывает топ-10 найденных кусков текста по их реальной релевантности).
Системные требования для локального RAG (On-Premise)
Если вы строите закрытый контур на базе открытых моделей (например, семейства Llama от Meta*):
- Модель уровня 8B параметров (FP8 квантование): GPU от 12 ГБ VRAM (RTX 4070 / 3060).
- Модель уровня 70B (для сложной аналитики): Связка из 2-4 видеокарт RTX 4090 или серверная H100.
- Векторная БД (Qdrant/Chroma): Хватает стандартного сервера с 16-32 ГБ RAM и быстрым NVMe диском.
Сравнение: Голая LLM против LLM + RAG
| Критерий | Стандартная LLM | LLM с RAG-архитектурой |
|---|---|---|
| Галлюцинации | Часто (выдумывает факты) | Редко (строго по контексту) |
| Актуальность данных | Заморожена на момент обучения | В реальном времени |
| Доступ к приватным файлам | Нет | Да |
| Стоимость обновления знаний | Высокая (нужен Fine-tuning) | Низкая (просто закинуть файл в БД) |
Мнение редакции: что это значит для рынка
Технология RAG произвела сдвиг парадигмы. Раньше компании пытались дообучать гигантские модели на своих данных, тратя сотни тысяч долларов на GPU. Это был путь в никуда: знания быстро устаревали, а модель все равно "забывала" детали.
Сегодня RAG позволяет любому бизнесу получить "Свой личный ChatGPT" за сущие копейки. Мы видим переход к Agentic RAG - когда нейросеть не просто ищет текст, но и сама принимает решение, в какую базу сходить, нужно ли сделать SQL-запрос к бухгалтерии или поискать ответ в интернете. Умение собирать эффективные RAG-системы стало самым востребованным навыком для Python-разработчиков в 2026 году.
*Деятельность компании Meta Platforms Inc. (соцсети Facebook, Instagram) признана экстремистской и запрещена на территории РФ.
Читайте также
Gemini 4 Argon против GPT-6 Astra: результаты тестов, возможности и цена
Google открыла доступ к Gemini 4 Argon, своей новой модели для программирования, сложных рассуждений и ИИ-агентов. В одних тестах она опережает GPT-6 Astra, в других уступает. Разбираем результаты, возможности, доступность и стоимость новой нейросети.
Meta* представила Muse Wonder: новая ИИ-модель конкурирует с ChatGPT и Claude
Meta* представила Muse Wonder и Muse Wonder Full, новые модели для программирования, работы с документами и автономных ИИ-агентов. Разбираемся, что они умеют, сколько стоят и есть ли основания считать их конкурентами ChatGPT и Claude.
Google Gemini 4 Argon: характеристики, бенчмарки и сравнение с GPT-6 Astra и Claude Fable 5.1
Google выкатила флагманскую мультимодальную модель Gemini 4 Argon с нативной поддержкой 10 млн токенов контекста и автономным логическим ядром. Независимые тесты показывают превосходство над GPT-6 Astra на 14% в кодогенерации и победу над Claude Fable 5.1 в комплексном рассуждении. Разбираем реальные бенчмарки, архитектурные сдвиги и актуальные цены API на осень 2026 года.